| ★この記事でわかること ・「暗黙知」「属人化した情報」「出せないデータ」の悩みに、共通の背景があること ・データを社外に出さずにAIを使う「ローカルLLM」という選択肢 ・クラウドAIとの違いと、それぞれの向き不向き ・ローカルLLMが力を発揮しやすい場面と、検討の次の一歩 |
「あの判断は、結局〇〇さんに聞かないと分からない」
「過去の不具合の記録はあるはずだが、どこにあるか誰も知らない」
「AIは気になるが、うちの図面や顧客情報は社外に出せない」
こうした悩みを抱える現場は少なくありません。
その結果、「AIはうちでは使えない」と検討を止めてしまうケースもあります。
しかし、こうした課題こそ、AIを活用しやすい領域でもあります。さらに、仕組みを選べば、データを社外に出さずにAIを利用することも可能です。
本記事では、その選択肢の一つである「ローカルLLM」について、仕組みやクラウドAIとの違い、向いている用途を紹介します。
※すでにローカルLLMをご存じで、「実際にどう検証を進めるか」を知りたい方は、ローカルLLM、導入前に「試乗」しませんか?サーバーを買う前にできる検証アプローチを紹介!もあわせてご覧ください。
目次
3つの悩みに共通するもの
冒頭に挙げた3つの悩みは、それぞれ別の問題に見えます。
ただ、共通している点があります。
暗黙知
ベテランの経験や判断基準が、その人の頭の中にしかない。本人に聞けば分かるものの、不在時には判断できない。
属人化した情報
報告書や議事録、過去のトラブル記録は残っているものの、保管場所が分散していて必要な情報を探し出しにくい。
出せないデータ
図面、仕様書、顧客情報など、AIに活用できそうな情報があっても、機密性や契約上の理由から社外のサービスへ送信できない。
3つに共通するのは、社内に価値のある情報があるのに、十分に活用できていないことです。
背景の一つには、これまで広く使われてきた生成AIの多くが、入力した情報を外部のサーバーで処理する仕組みだったことがあります。
LLMには「クラウドで使う方法」と「自社で動かす方法」がある
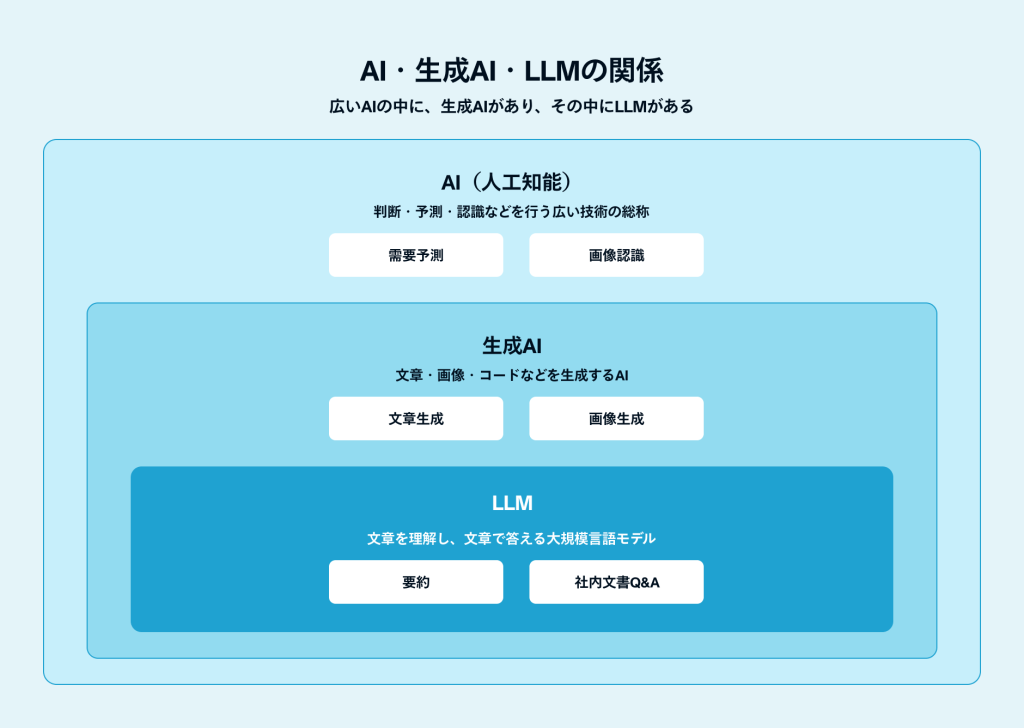
ChatGPTなどの生成AIでは、LLM(大規模言語モデル)と呼ばれる技術が使われています。文章で質問すると、それに対する回答が文章で返ってくる仕組みです。
一般的なクラウド型の生成AIでは、入力した文章がインターネットを経由してサービス提供者のサーバーへ送られ、そこで処理されます。導入しやすく、高性能なモデルをすぐに利用できるのが大きなメリットです。
一方、入力する情報の種類によっては、社外のサーバーへ送信すること自体が問題になります。
そこで選択肢になるのが、LLMを自社のサーバーやPC上で動かす方法です。これを「ローカルLLM」と呼びます。
ローカルLLMでは、モデルを自社管理の環境に配置できます。構成によっては、質問、社内文書、AIが生成する回答までを社内環境の中で処理できます。
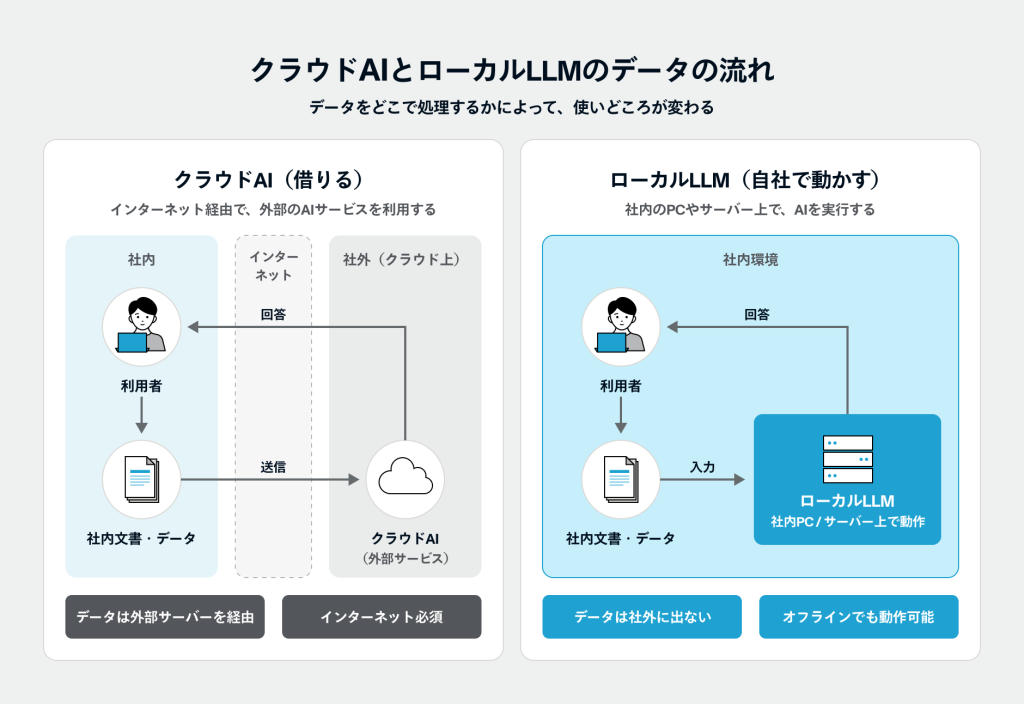
また、外部通信を必要としない構成にすれば、インターネットに接続できない環境でも利用できます。
工場の閉域ネットワークなどでは、この特徴が大きなメリットになります。
クラウドAIとローカルLLMの違い
両者の主な違いを整理すると、次のようになります。
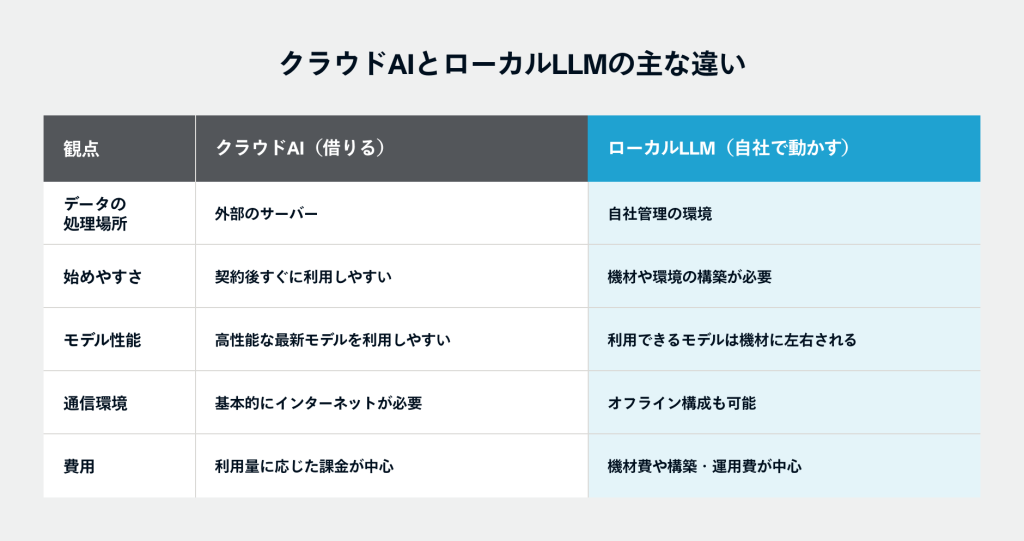
ローカルLLMは、すべての用途でクラウドAIより優れているわけではありません。
特に、幅広い分野について高い推論能力を求める場合は、クラウドで提供されている大規模モデルのほうが適していることがあります。
一方、用途を限定すると状況は変わります。
たとえば、
・社内文書を検索する
・過去の報告書を要約する
・手順書をもとに質問へ回答する
・定型的な文書の下書きを作る
といった用途です。
こうした業務では、ローカル環境で動かせるモデルでも実用性を検証しやすくなっています。選ぶ基準は、単純なモデル性能だけではありません。
どの情報を扱うのか、どこまで社外へ出せるのか、どの程度の回答精度が必要なのか。これらを整理したうえで、クラウドAIとローカルLLMを使い分けることが重要です。
なぜ今、ローカルLLMを検討しやすくなったのか
以前は、自社でLLMを動かすには高価な計算機や専門知識が必要でした。現在は、その状況が変わりつつあります。
1. 小型でも実用的なモデルが増えた
LLMの小型化が進み、比較的限られた計算資源でも利用できるモデルが増えています。高性能なPCやサーバーで動かせるモデルもあり、用途を限定すれば業務利用を検討できるケースが出てきました。
2. 周辺ツールが増えた
LLMをローカル環境で動かすためのソフトウェアや、社内文書を検索して回答に利用するためのツールも整ってきました。
以前と比べると、検証環境を構築するためのハードルは下がっています。
3. 小規模な検証から始めやすくなった
最初から大規模な設備を導入する必要はありません。まずは手元のPCや検証用サーバーを使い、自社の文書を対象に、
「どの程度検索できるのか」
「質問に対してどの程度正確に回答できるのか」
を確認する方法があります。結果を見てから、本格導入するかどうかを判断できます。
ローカルLLMが使いやすい3つの場面
ローカルLLMの特徴が活きやすい代表的な場面を紹介します。
場面①製造現場:ベテランの知見や過去の記録を検索できるようにする
「この症状なら、まずここを確認する」
こうした判断基準は、ベテラン社員の経験や、過去の不具合報告、作業記録の中に蓄積されています。
しかし、必要な情報を人が毎回探すのは簡単ではありません。社内の報告書や手順書を検索対象にし、LLMと組み合わせることで、
「この症状と似た事例は過去にあったか」
「そのとき、どのような対応をしたか」
といった質問から情報を探せる仕組みを作れます。図面や不良データを外部サービスへ送信できない製造現場でも、ローカル環境であれば検討しやすくなります。
場面②金融・自治体:機微な情報を扱う業務で利用する
顧客情報や個人情報を扱う組織では、外部の生成AIサービスへ入力できる情報が制限されていることがあります。
ローカルLLMであれば、自社管理の環境内で文書検索、要約、文章作成などを行う構成を検討できます。
もちろん、ローカル環境に置くだけでセキュリティ対策が完了するわけではありません。アクセス権限、ログ管理、データ保管、端末管理などの設計は別途必要です。
そのうえで、外部サービスにデータを送信しない構成を取れることは、大きな選択肢になります。
場面③インターネットを利用できない現場:オフライン環境でAIを使う
工場の閉域ネットワーク、山間部の建設現場、船内など、インターネット接続を利用できない環境もあります。
ローカルLLMは、必要なモデルやデータをあらかじめ環境内に用意しておけば、外部通信なしで動かすことができます。
そのため、
・マニュアル検索
・過去事例の検索
・作業報告書の作成支援
といった用途で利用できる可能性があります。クラウドAIを利用しにくかった環境でも検討できる点は、ローカルLLMならではの特徴です。
ローカルLLMを使わないほうがよい場合もある
ローカルLLMは、データを外に出せない企業にとって有効な選択肢ですが、すべてのケースで必要になるわけではありません。
たとえば、
「個人情報が含まれているため、そのままでは外部サービスへ入力できない」
という課題であれば、利用前に氏名や固有名詞を削除・匿名化することで対応できる場合があります。
その場合、ローカルLLMの環境を構築するより、既存のクラウドAIを安全に利用する仕組みを整えたほうが簡単です。
また、「社内の情報をAIで活用したい」と考えても、そもそも情報が文書やデータとして残っていなければ、LLMから参照することはできません。
ベテラン社員の頭の中にしか情報がないのであれば、まずはヒアリングや作業記録を通じて、知識を残すところから始める必要があります。
ローカルLLMを検討しやすいのは、主に次の2つの条件が揃っているケースです。
・社外に出せない、または出したくない情報がある
・AIに活用できる文書やデータがすでに社内にある
どちらかが欠けている場合は、別の方法のほうが低コストで実現できることもあります。まずは「なぜローカルLLMが必要なのか」を整理することが重要です。
まとめ:「使えるか」ではなく「どこで使うか」を考える
暗黙知、属人化した情報、社外に出せないデータ。これらに共通しているのは、社内に情報があるにもかかわらず、十分に活用できていないことです。
ローカルLLMは、自社管理の環境でLLMを動かすことで、機密性の高い情報を扱いながらAIを活用するための選択肢になります。
一方、モデル性能や構築・運用コストではクラウドAIのほうが適しているケースもあります。重要なのは、最初からどちらか一方に決めることではありません。
扱うデータ、利用する場所、必要な性能を整理し、自社の業務に合った方法を選ぶことです。実際にローカルLLMを検討する場合も、最初から大規模な導入を行う必要はありません。
まずは自社の文書を使った小規模な検証から始め、回答精度や使い勝手を確認していく方法があります。具体的な検証の進め方については、ローカルLLM、導入前に「試乗」しませんか?サーバーを買う前にできる検証アプローチを紹介!の記事で解説しています。
モンスターラボでは、ローカルLLMをテーマにしたセミナーも開催しています。実際のデモや検証方法にご興味がある方は、アーカイブや資料もあわせてご覧ください。
セミナー一覧はこちら
モンスターラボはAI導入を支援する伴走型パートナー
モンスターラボでは、世界各国のスペシャリストがチームを組み、デジタルサービス・プロダクトの開発をはじめ、UX/UIデザイン、ブランド開発、グロース支援などを行っています。
ビジネスの上流工程では、デジタル領域の知見を持つコンサルタントが課題を整理し、目的に応じたソリューションを提案します。
開発では、さまざまなプラットフォームや先端技術に対応できる体制を整えています。アジャイル開発、国内外のリソースを活用した開発体制の構築、リリース後の保守・運用や品質改善まで支援しています。
また、各国の拠点やネットワークを活用し、海外展開の支援も行っています。対象地域での事業検討や現地調査など、これまでの支援実績をもとにサポートします。
モンスターラボが提供するサービスの詳細は、以下をご覧ください。
直近のイベント
記事の作成者・監修者
安藤 彬斗(株式会社モンスターラボ ソリューションアーキテクト)
2024年にモンスターラボに入社。大手総合商社グループのデータ連携基盤構築、大手建材メーカーの設計業務を支援するAIアプリケーション開発など、複数の案件にテクニカルリードをはじめとした多様な役割で参画。Azure / AWS / GCP を横断したクラウドインフラ、データエンジニアリング、フルスタック開発まで幅広く担う。 顧客との要件整理から実装までを一貫して担い、技術と事業をつなぐことで、構想を動くプロダクトとして形にする価値創出に取り組んでいる。
関連記事