ローカルLLM、導入前に「試乗」しませんか?サーバーを買う前にできる検証アプローチを紹介!
目次
はじめに
この記事では、「ローカルLLMを本格導入する前に、どのように検証するか」をテーマに、私たちが現在取り組んでいる検証方法を交えながら、導入判断までの進め方を紹介します。特に、以下に当てはまる方に読んでいただきたい記事です。
・ローカルLLMに興味があるが、何から手を付ければいいかわからない
・導入を検討したが、費用や検証方法の壁で止まってしまった
・機密データがあるため、クラウドの生成AIを業務で使いきれていない
➡︎AI時代の未来を切り拓くAIエージェント構想<資料ダウンロード>
ローカルLLMとは
「ローカルLLM」とは、LLM(大規模言語モデル)を、ChatGPTのようなクラウド事業者のサービス経由ではなく、自社のサーバーやPCなど自組織の管理下にある環境で動かす利用形態のことです。
特定のモデルの種類を指す言葉ではなく、AIモデルの本体(重みファイル)を手元の環境に置いて動かす方式を指します。「オンプレミスLLM」「セルフホストLLM」と呼ばれることもあります。
ローカルLLMの仕組みやクラウドAIとの違い、向いている場面については、「データは外に出せない」でAIを諦めた会社が、次に検討すべきことでくわしく解説しています。
入力データを外部サービスへ送信しない構成にできるため、設計図面、品質データ、顧客情報といった外部サービスへ送信しにくいデータをAIで活用できる点が特長です。インターネットに繋がらない工場のような環境でも使えます。
少し前まで、LLMを自前で動かすのは研究者や一部のエンジニアの領域でした。しかし、近年、オープンなモデルの性能向上が進み、それを動かすソフトウェアも整ってきたことで、企業でも検証しやすいものになっています。
ローカルLLMという選択肢を知り、技術的に可能だとわかっても、その後の検証方法や投資判断で検討が止まるケースは少なくありません。
ローカルLLMの検討が止まりやすい3つのポイント
導入検討時によく挙がる課題を3つ紹介します。
あるある①:見積もりを見て、稟議が止まる
GPUを搭載したサーバーには一定の初期投資が必要です。それに加えて、設置スペース、電源や空調、保守の体制。工場に置くなら、現場の設備側の調整も必要になります。
その際、課題になるのが次の点です。導入後に必要な精度が得られるか。十分な検証材料がなければ、投資判断を進めにくくなります。
あるある②:「使えるかどうか」の判断基準が、そもそもわからない
仮に予算が確保できたとしても、次の疑問が待っています。何をどこまで確認すれば、業務利用可能と判断できるのか。
回答の精度なのか、応答の速さなのか、同時に何人が使えるかなのか。評価基準が決まっていないと、情報収集だけが続き、導入判断につながりません。
あるある③:手元のPCで試したが・・・
行動力のある担当者なら、手元のPCで小さなモデルを動かしてみた方もいるでしょう。まずはモデルが動作することを確認できます。
しかし、本番で想定するモデルとはサイズが違う、ネットワーク環境も違う、扱うデータも違う。この結果を持って「本番ではこうなります」とは言えず、本番導入の判断材料としては不十分です。
なぜ検討が止まるのか
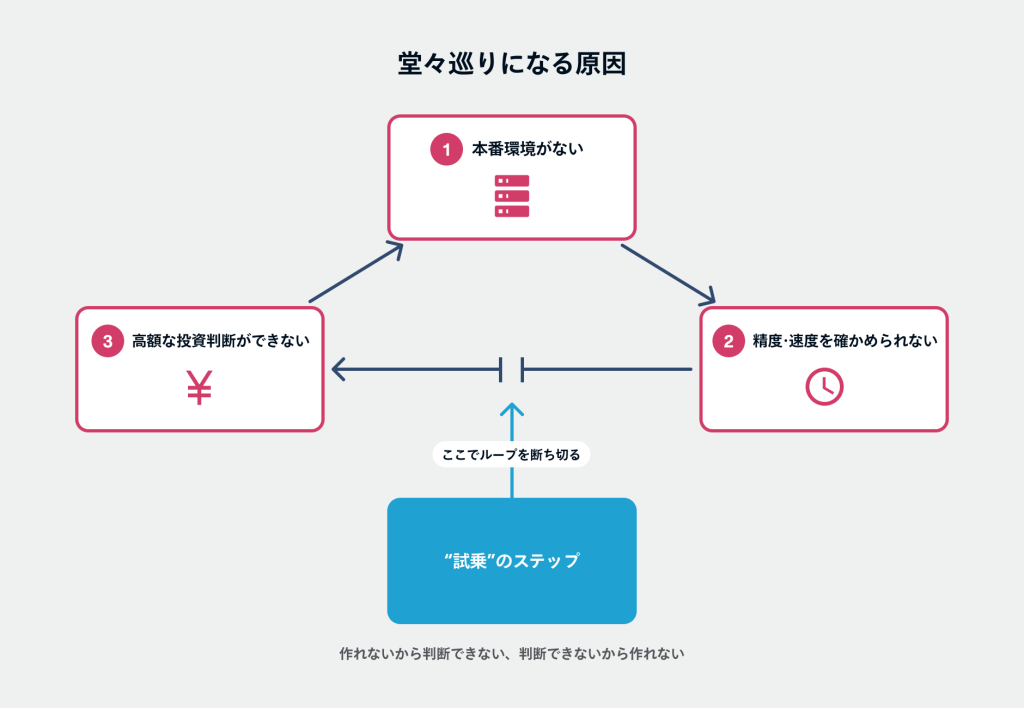
こうした状況が起きる理由の一つは、検証と本番構築が一体になっていることです。
3つのあるあるに共通しているのは、本番環境を構築しなければ十分な検証ができない、という前提です。本番環境を作れば検証できますが、そのためには事前に設備投資が必要になります。
車を購入する前に試乗するように、ローカルLLMでも本番導入前に主要な条件を確認できると、投資判断がしやすくなります。
解決策:本番を模した「シミュレーション環境」で先に検証する
検証方法の一つが、本番のオンプレ構成を模したシミュレーション環境をクラウド上に用意し、そこで先に検証するアプローチです。
単にクラウド上で動かすのではなく、本番で結果に影響する条件を可能な範囲で揃えます。私たちモンスターラボでも現在、お客様が本格導入前に検証できるよう、このシミュレーション環境の構築に取り組んでいます。
大まかに、次のステップで進めていきます。
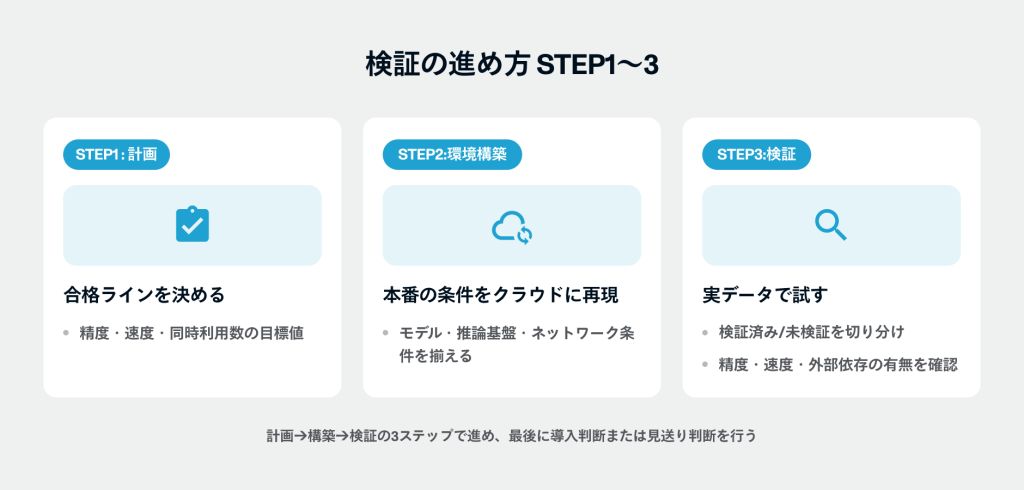
STEP1 計画:「何を確認できたら導入と言えるか」を決める
最初に、検証の目的と合格ラインを明確にすることが必要です。
・この業務のこの作業で、このレベルの回答が返ればOK
・応答は何秒以内、同時利用は何人
評価基準が曖昧なまま環境を構築すると、検証結果から導入可否を判断できません。あわせて、本番で想定するモデルやサーバー性能もこの段階で仮決めします。
STEP2 環境構築:本番の条件をクラウド上に再現する
クラウドのGPU環境上に、本番で利用予定のモデルや推論ソフトウェア、そして外部に依存しない閉じたネットワークを設計し、本番で結果を左右する条件を揃えて組み上げます。
また、クラウドのGPUは使った時間だけの課金です。物理サーバーを購入する前に、想定構成の性能を確認できます。
STEP3 検証:実データを使って評価する
STEP1で決めた合格ラインに対して、実際の業務データ・想定ユースケースで検証します。
結果が出たら、「条件を満たした項目」「満たさなかった項目」「今回確認できなかった項目」を整理して、導入判断(あるいは見送り判断)の材料にします。
クラウドでの検証結果は本番環境でも使えるのか
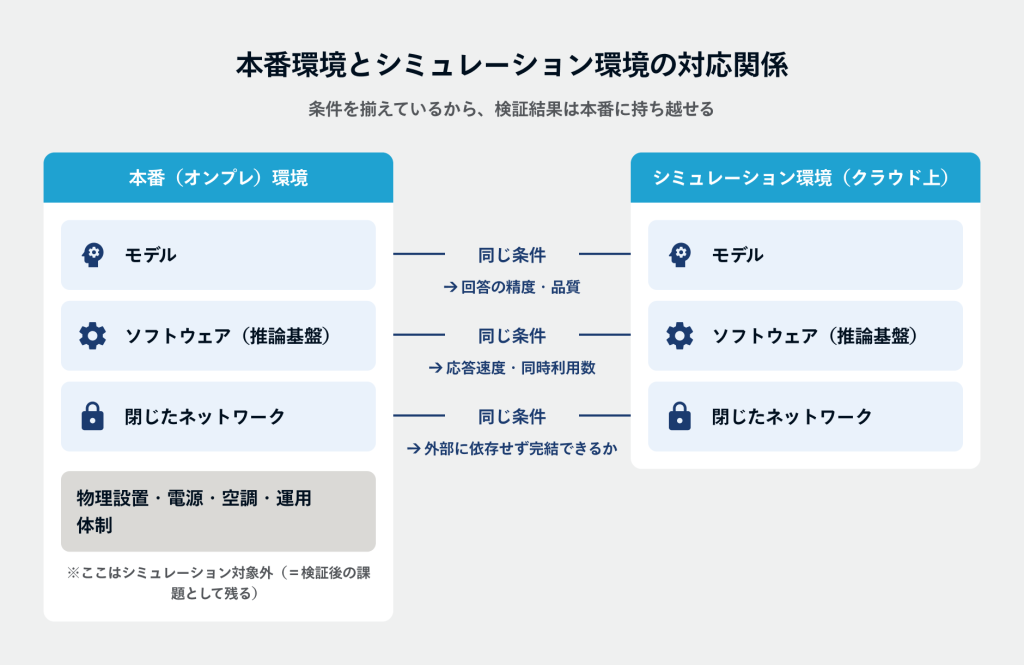
条件を揃えて検証すれば、多くの項目について本番環境の判断材料にできます。
・モデルとソフトウェアを揃える → 回答品質を確認するための参考結果として利用できる
・GPUの性能を本番想定に揃える → 応答速度や処理量を見積もる材料になる
・閉じたネットワーク制約を再現する → 外部サービスに依存せず処理を完結できるか確認できる
注意点:シミュレーションで確認できないことも残る
一方で、工場への物理的な設置、電源や空調、現場の運用体制などは、シミュレーションでは検証できません。
ただ、この方法では、確認済みの項目と未確認の項目を切り分けられます。導入判断では、確認済みの項目と残っている課題を整理しておくことが重要です。
「精度と速度は確認済み。残るリスクは設置と運用のみ」まで整理できていれば、導入可否を判断しやすくなります。
➡︎AI時代の未来を切り拓くAIエージェント構想<資料ダウンロード>
まとめ
ローカルLLMの導入検討で多くの企業が止まってしまうのは、技術や予算だけではなく、本格導入前の検証方法が明確になっていないことも要因の一つでした。
・「何を確認できたら導入か」の合格ラインを先に決める
・本番の条件を模したシミュレーション環境をクラウド上に用意する
・検証済み/未検証を切り分けて、判断材料にする
本番環境への投資前に、必要な条件を検証することができます。まずは小規模な検証から始める方法があります。
モンスターラボでは現在、このシミュレーション環境の構築に取り組んでいます。自社のデータや利用条件で検証できるか確認したい段階からご相談いただけます。
ローカルLLMでお悩みの際は、モンスターラボにご相談ください!
サービス・プロダクト開発を検討している企業ご担当者様へ
モンスターラボは、約20年にわたるサービス・プロダクト開発実績から得られたデジタル領域の知見や技術力を活かし、デジタルプロダクト開発事業を展開しています。
先端テクノロジーに対応した高度なIT人材があらゆるプラットフォーム上での開発を支援します。アジャイル開発とDevOpsによる柔軟な開発進行や、国内外のリソースを活用したスケーラブルな開発体制の構築も可能です。また、リリース後の保守運用や品質向上支援まで伴走可能です。
モンスターラボが提供するサポートの詳しい概要は以下リンクをご確認ください。
直近のイベント
記事の作成者・監修者
安藤 彬斗(株式会社モンスターラボ ソリューションアーキテクト)
2024年にモンスターラボに入社。大手総合商社グループのデータ連携基盤構築、大手建材メーカーの設計業務を支援するAIアプリケーション開発など、複数の案件にテクニカルリードをはじめとした多様な役割で参画。Azure / AWS / GCP を横断したクラウドインフラ、データエンジニアリング、フルスタック開発まで幅広く担う。 顧客との要件整理から実装までを一貫して担い、技術と事業をつなぐことで、構想を動くプロダクトとして形にする価値創出に取り組んでいる。
関連記事